
【编者按】向ChatGPT输入问题,几秒钟就能得到回答。它可以总结报告、翻译外语,也能解决复杂问题。如今,AI已不再是什么特殊技术,而是人人都在日常生活中使用的工具。
作为一名IT记者,我有机会比其他人更早接触新技术和AI相关消息。2022年末ChatGPT问世时也是如此。我向身边的人介绍它,但得到的反应很冷淡。
“那是什么?”“AI准确度不是很低吗?”“等它商业化了再用吧。”
近四年过去了。如今,学生们用AI完成作业,职场人士用ChatGPT撰写报告。企业也开始推进“AI转型(AX)”,改变组织架构和工作方式。
我忽然很好奇,这样的AI究竟是如何诞生的。所有计算并非都在智能手机里完成。我们发送的问题会经由互联网传送到数据中心。那里安装的服务器中配有英伟达GPU,以及SK海力士、三星电子等企业生产的HBM。HBM是一种将多层DRAM堆叠而成的高性能存储器,而DRAM则是在硅晶圆上制造出来的。
有趣的是,ChatGPT问世之际,半导体市场正处于低迷期。受新冠疫情期间个人电脑和智能手机需求放缓影响,存储芯片价格下跌,三星电子和SK海力士的业绩也受到冲击。
然而,随着生成式AI迅速普及,情况发生了变化。数据中心投资增加,AI运算所需的GPU和HBM需求也急剧上升。
SK集团会长崔泰源曾于2024年11月预测,随着下一代ChatGPT问世,AI市场很可能在2027年前后大幅扩大。
AI是如何与庞大的半导体产业相连的?我们从ChatGPT出发,沿着产业链一路追溯到半导体原料——沙子。
1. AI服务(我们每天使用的AI)
ChatGPT、谷歌Gemini和Anthropic Claude都是知名的生成式AI服务。
用户输入问题后,AI模型会处理内容并生成回答。它们也可以撰写文章或翻译外语,还有一些AI服务能够生成图像和视频。
我们看到的聊天界面并不会完成全部AI运算。用户输入问题后,问题会通过互联网传送到服务器。服务器上的AI模型生成回答,再将结果发送给用户。
当然,部分AI功能也可以在智能手机或个人电脑上运行。不过,大规模生成式AI服务主要依靠数据中心处理运算。
2. AI企业(AI模型由谁开发?)
ChatGPT由美国OpenAI开发。谷歌开发了Gemini,Anthropic开发了Claude。Meta和中国AI企业也在开发自己的模型。
AI企业利用海量数据训练模型。之后,用户提出问题时,经过训练的模型便会生成回答。
这一过程主要分为训练和推理。训练(Training)是AI通过数据学习模式的过程;推理(Inference)则是完成训练的模型回答问题或生成新结果的过程。我们向AI提问并获取回答,主要属于推理。
训练和推理都需要大量计算。开发大型AI模型尤其需要惊人的运算能力。这正是AI企业投入巨资建设数据中心、获取高性能半导体的原因。
3. 数据中心(AI实际运行的地方)
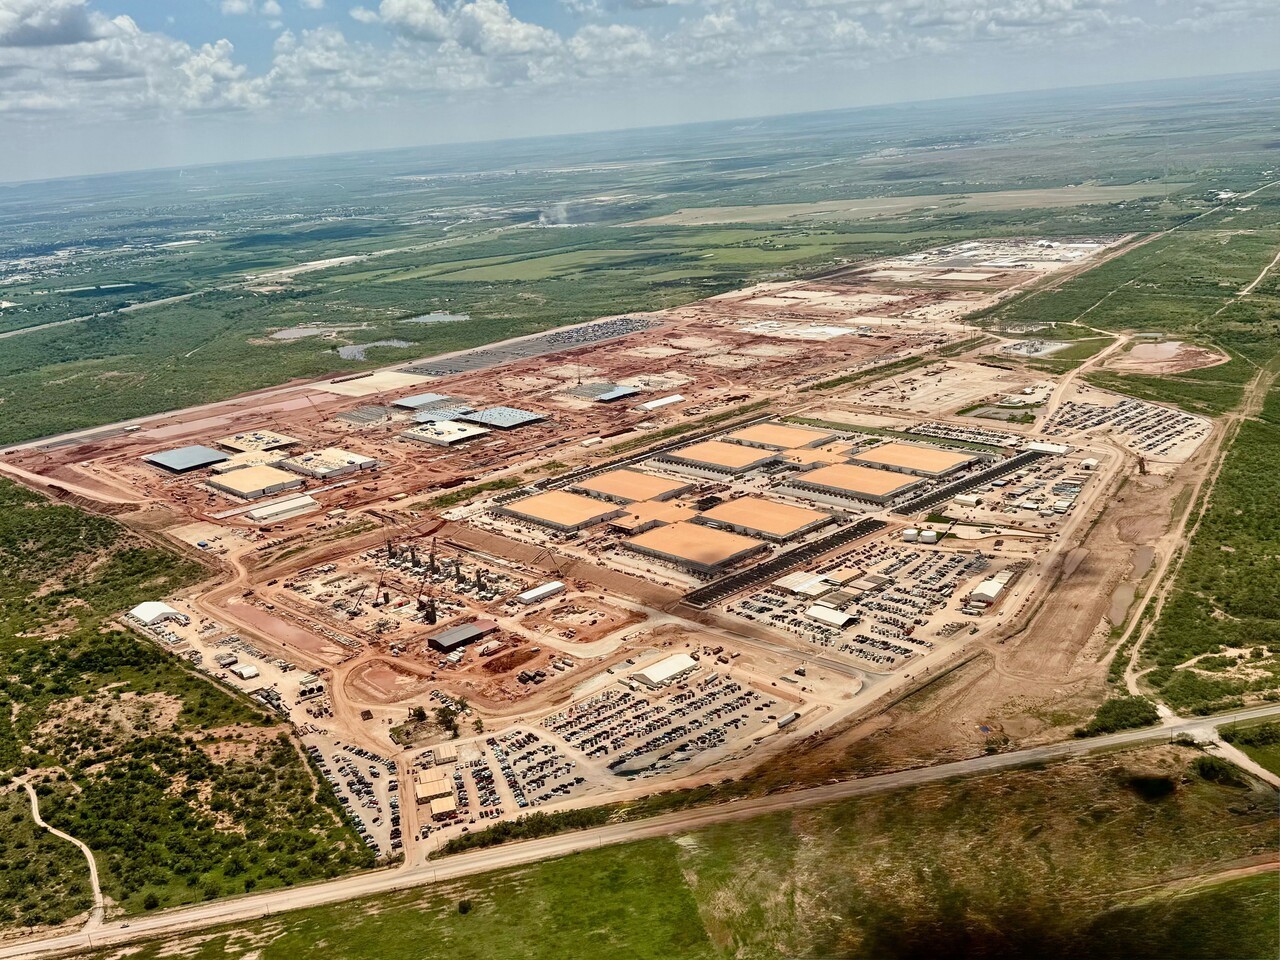
数据中心是集中运行大量服务器的设施。从外面看,它是一栋大型建筑。内部排列着安装服务器的机柜,还配备供电设施和散热冷却设备。
AI企业在数据中心训练模型并运营服务。它们既可以使用自有数据中心,也可以向云服务企业租用算力。
训练大型AI模型需要让大量半导体同时运行。运营服务时,也需要足够的运算能力来处理众多用户的请求。
电力和热量是两大难题。高性能半导体运行时,耗电量会增加,也会产生大量热量。因此,冷却设施至关重要。
随着AI市场扩大,除了建设数据中心,如何保障电力供应和改进冷却技术也成为重要课题。
4. 服务器(驱动AI运行的计算机)
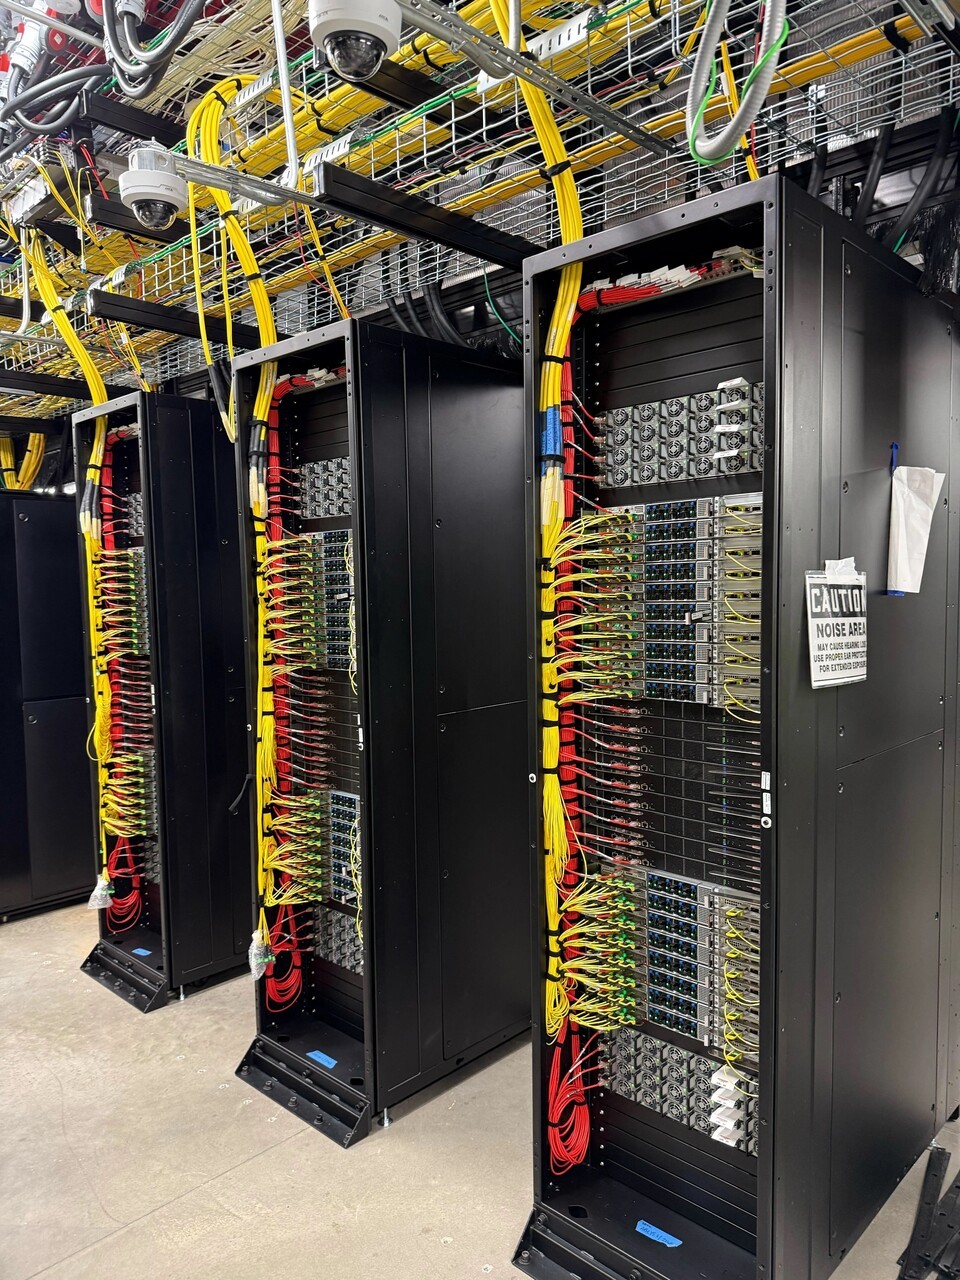
服务器从本质上说也是计算机。它像我们使用的个人电脑一样处理运算并存储数据,区别在于用途和规模。
个人电脑主要供一个人使用,而服务器的设计目标是处理大量用户的请求。
服务器内配有CPU、内存和存储设备。用于AI运算的服务器还会使用GPU等加速器。CPU负责管理计算机整体运行并处理各种指令,AI加速器则负责快速完成大规模计算。
将多台服务器连接起来,就能训练更大的AI模型,或同时处理更多用户的请求。不过,并非所有AI加速器都会安装在普通服务器上。例如,谷歌TPU等芯片有时会被连接起来,在专用系统中运行。
AI系统的关键在于能否快速处理大量计算。GPU和TPU便由此登场。
5. GPU与TPU(负责AI运算的半导体)
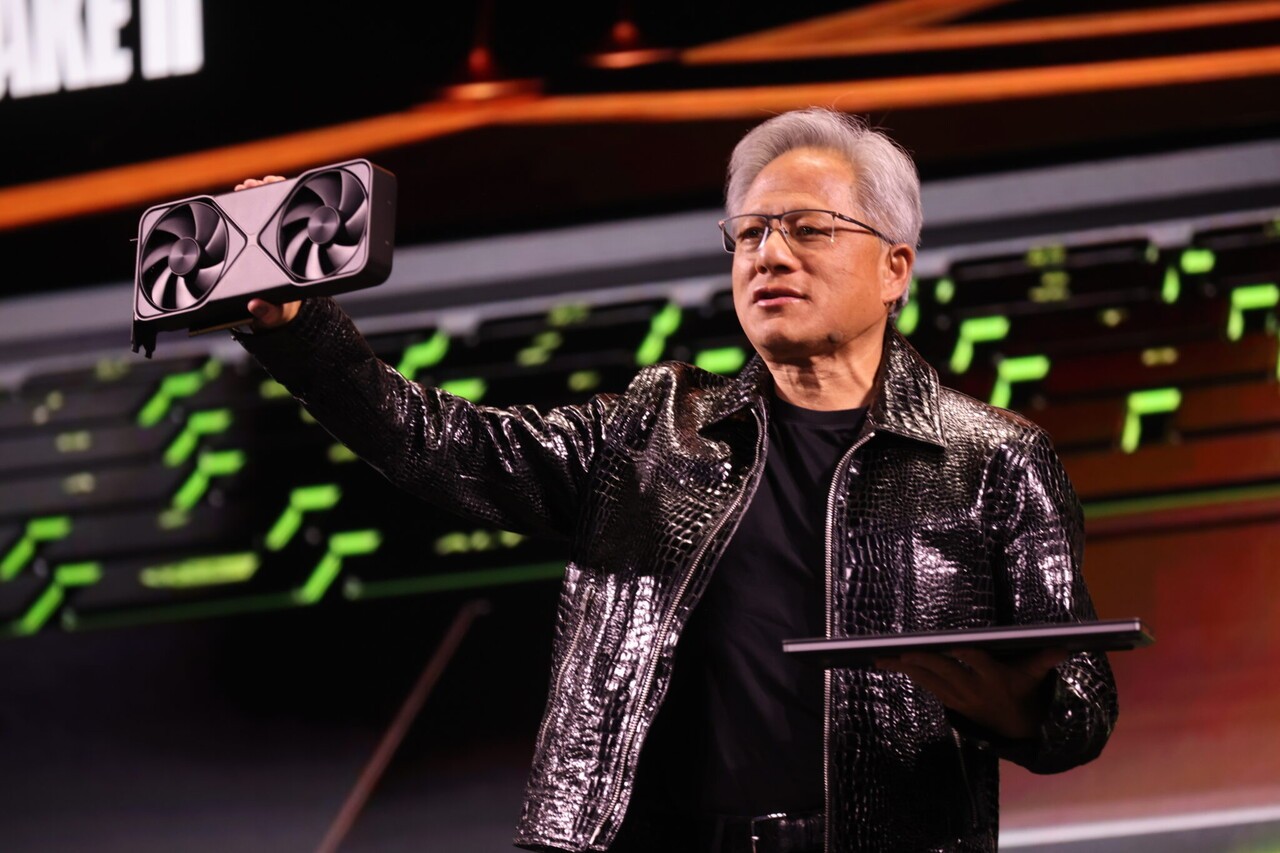
AI运行需要进行海量计算。能够快速处理这些任务的半导体被称为AI加速器。
代表性产品包括英伟达GPU和谷歌TPU。GPU是图形处理器(Graphics Processing Unit),最初是为处理游戏或视频所需的图形而发展起来的。它擅长同时执行大量计算,因此也被广泛用于AI训练和推理。
英伟达不断发展GPU,使其能够用于AI运算。该公司还提供相关软件和系统,因此在AI半导体市场占据了重要地位。
谷歌则选择了另一条道路,自行开发专为AI运算设计的TPU。TPU是张量处理器(Tensor Processing Unit),是一种为快速处理AI模型中反复出现的大规模矩阵运算而设计的半导体。谷歌将TPU用于自家的AI服务和云基础设施。
GPU和TPU的设计目的与结构有所不同。GPU可广泛用于从图形处理到AI的各种运算;TPU则专门针对机器学习所需的计算进行了优化。
二者也有共同点:都必须快速处理大量数据。无论运算速度多快,如果不能及时获得所需数据,性能就难以充分发挥。HBM由此登场。
6. HBM(为AI加速器提供数据的存储器)
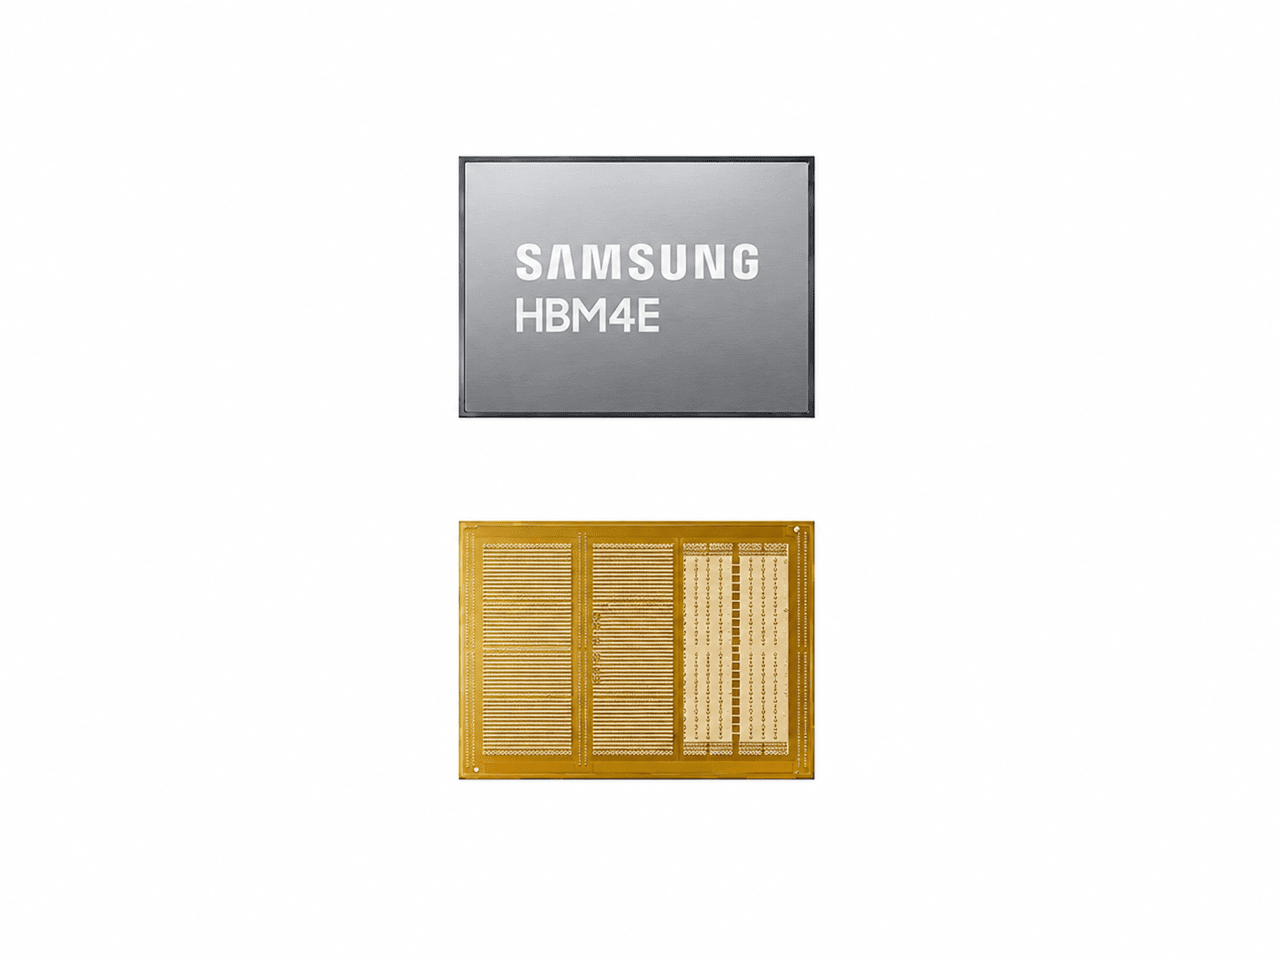
HBM是高带宽存储器(High Bandwidth Memory)的缩写。简单来说,它是一种经过设计、能够一次快速传输大量数据的存储器。
AI为什么需要存储器?GPU和TPU负责计算,存储器则保存计算所需的数据。构成AI模型的大量数值,以及运算过程中产生的数据,也会存储在内存中。AI加速器读取这些数据进行计算,再将结果写回内存。
问题在于速度。AI加速器能在短时间内处理海量数据。如果存储器无法及时提供数据,运算设备就只能等待。也就是说,即使使用再快的GPU,也难以充分发挥其性能。
HBM正是为缓解这一问题而开发的。它将多颗DRAM芯片垂直堆叠,并在芯片之间建立连接,从而实现大量数据的并行传输。
通过先进封装技术,HBM会被安装在GPU等AI加速器附近,以缩短数据传输距离并获得更高带宽。谷歌TPU也会根据产品型号使用HBM。
SK海力士、三星电子和美国美光是代表性的HBM制造商。随着生成式AI普及,HBM需求也大幅增加。
7. DRAM(制造HBM的基础半导体)
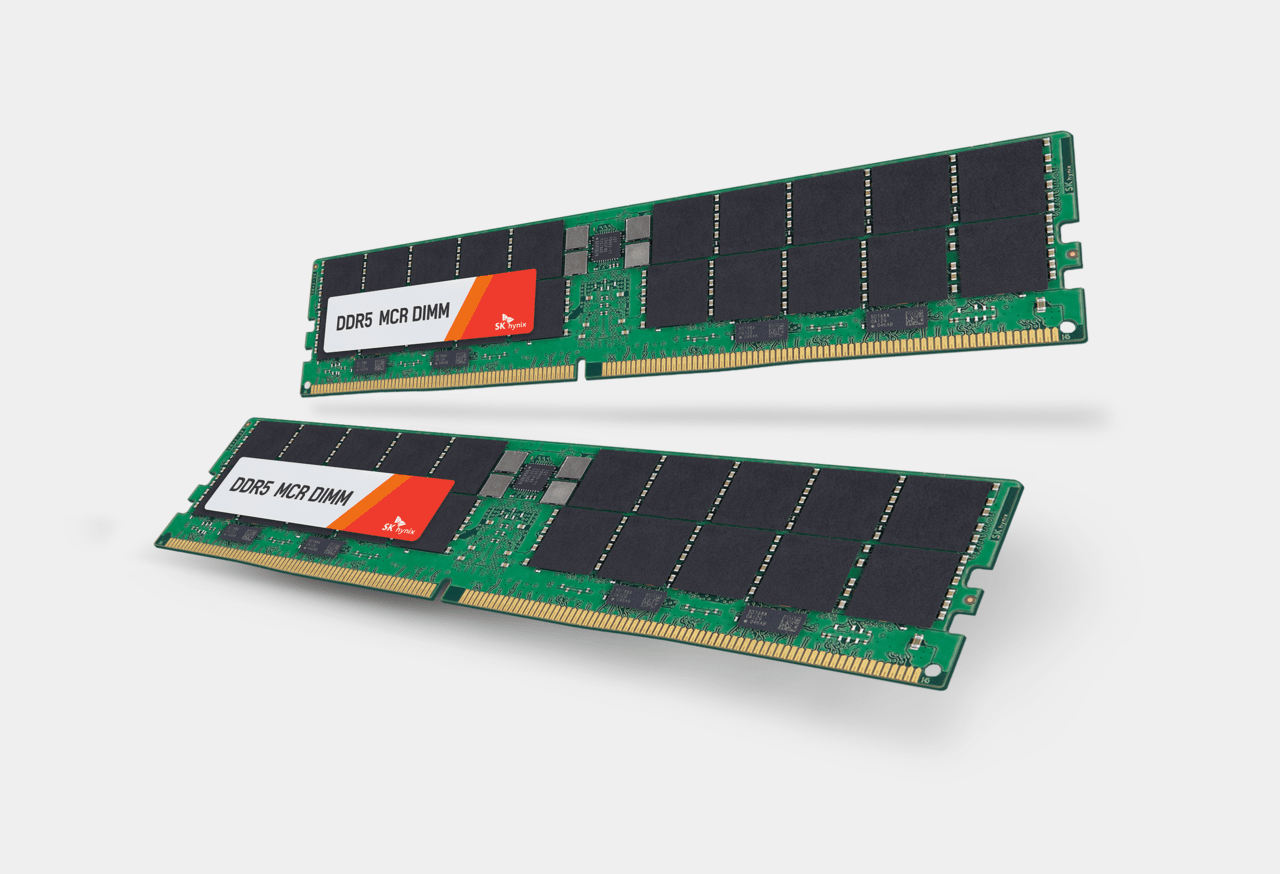
DRAM是动态随机存取存储器(Dynamic Random Access Memory)的缩写。
它是一种在计算机运行期间临时存储所需数据的半导体。处理文档或运行程序时,也会用到DRAM。
断电后,DRAM中存储的数据就会消失。它与用于长期保存照片和文件的存储设备作用不同。
HBM从根本上说也采用了DRAM技术。多颗DRAM芯片垂直堆叠,并通过精细的连接通道传输数据。其中一项代表性技术是TSV。
TSV是硅通孔(Through-Silicon Via)的缩写,指垂直贯穿硅芯片的电气连接通道。利用这项技术,堆叠起来的存储芯片之间就能快速传输数据。
DRAM是如何制造的?DRAM也是一种半导体。首先,在一片圆形薄板上制造大量电路,然后经过检测,再切割成小芯片。这种圆形薄板就是晶圆。
8. 晶圆(制造半导体的圆形薄片)
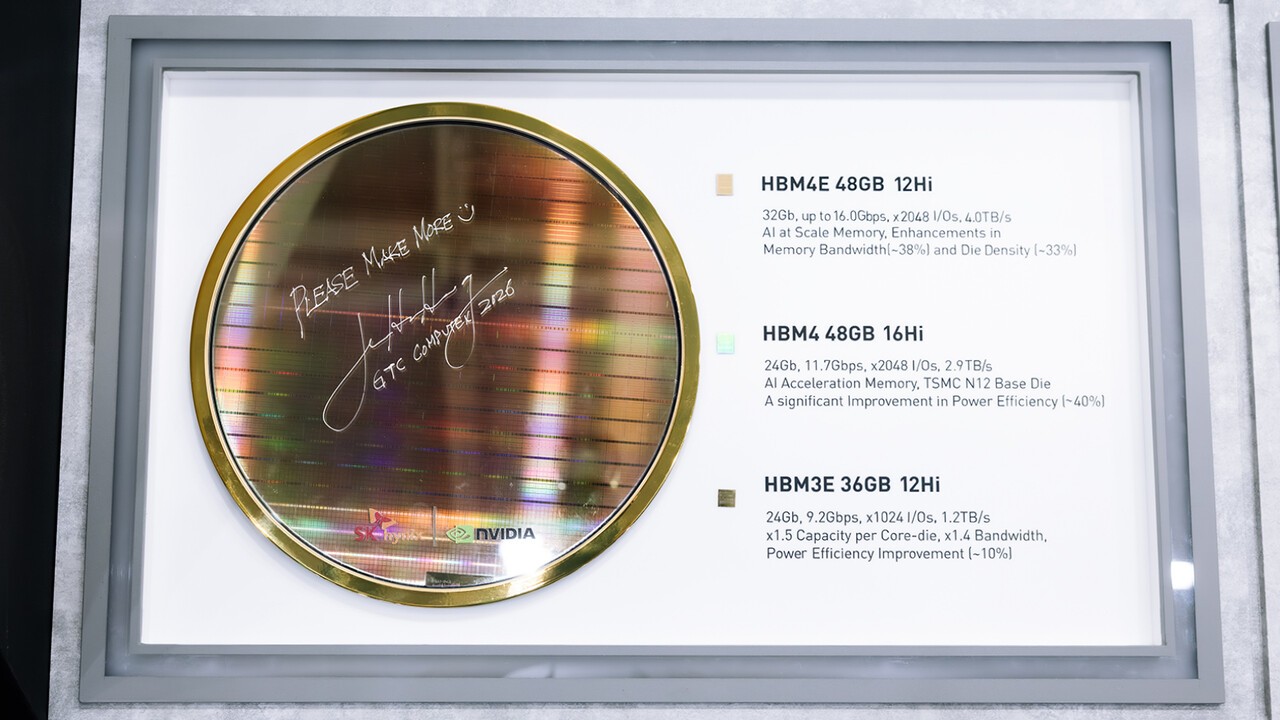
在半导体工厂的照片中经常可以看到一种圆形薄片,那就是晶圆(Wafer)。
包括DRAM在内的半导体,都是在晶圆上刻制精细电路制造而成。一片晶圆可以生产多个半导体芯片。
晶圆的主要材料是硅(Silicon),中文也称硅,元素符号为Si。用于半导体的硅必须经过提纯,去除微量杂质,以达到很高的纯度。
经过提纯的硅会被加工成薄圆片,随后在其上形成电路。之后再经过检测和切割,分成独立芯片并进行封装。那么,制造晶圆所用的硅从哪里来?
9. 沙子与石英(追溯半导体原料)
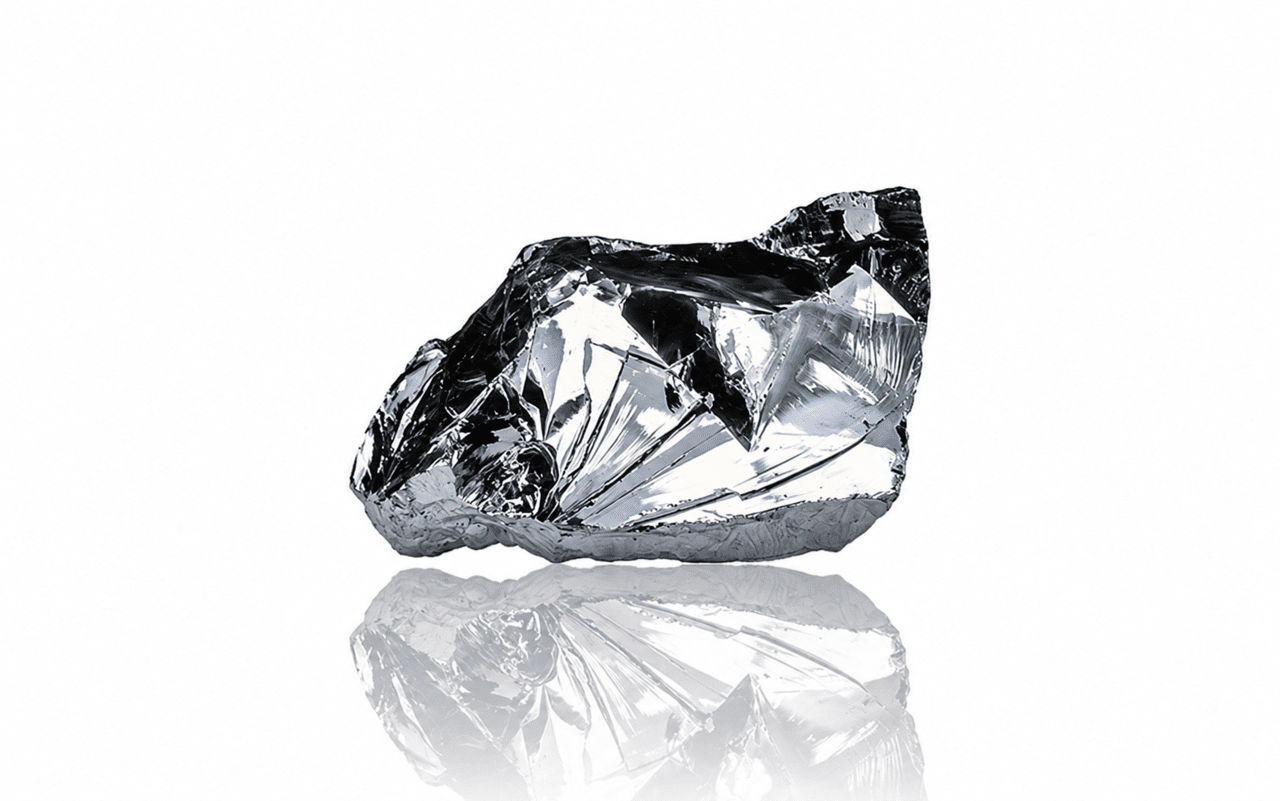
硅是一种较为常见的元素。沙子和石英中都含有二氧化硅(SiO₂),它是由硅和氧结合而成的物质。在半导体产业中,硅主要取自高纯度石英等适宜原料。
首先对原料进行加工,生产硅;随后去除杂质,将其提纯至半导体制造所需的高纯度。提纯后的硅会被制成单晶,再切割成薄片,制成晶圆。
DRAM在晶圆上制造而成。将多层DRAM堆叠起来,就能制成HBM。HBM则为GPU和TPU等AI加速器提供数据。
AI加速器在数据中心中用于训练模型并生成回答,最终,这些结果会成为我们所使用的AI服务。
当然,并不是从海滩上抓一把沙子就能直接制造半导体。半导体用硅必须经过严格的提纯和制造工序。
最后:AI改变了半导体产业
生成式AI的普及正在改变半导体市场的需求结构。在以个人电脑和智能手机为中心的存储芯片市场中,AI已成为新的增长动力。
随着AI模型不断升级,GPU和TPU等AI加速器的需求也在增长。为大规模运算快速提供数据的HBM,也已成为核心半导体。
AI产业的增长不仅带动半导体需求,也推动服务器、网络设备以及电力和冷却基础设施的投资。AI服务的扩张正在影响整个相关产业。
希望这篇文章能为理解那些看似熟悉、却又让人觉得难懂的AI与半导体,提供一点帮助。