
微软(MS)公布了上周全球范围内Outlook和Microsoft 365服务大规模故障的原因。调查确认,去年7月发布的服务器修复代码存在潜在缺陷,网络流量增加与服务器容量下降叠加,导致连锁故障。
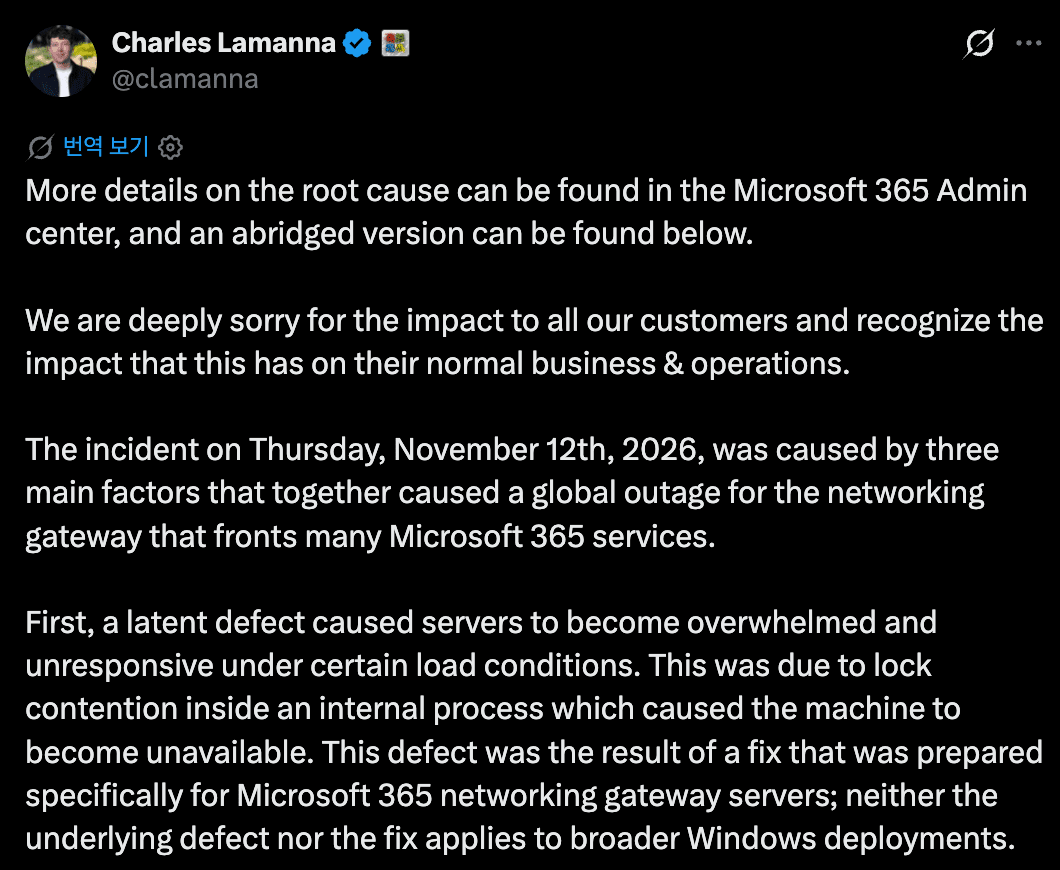
微软负责Copilot、智能体及平台业务的高级副总裁查尔斯·拉马纳于当地时间16日在自己的X账号上说明了12日故障的原因及恢复过程,并正式致歉。他表示:“我们对给所有客户造成的影响深表歉意,也意识到这影响了他们的正常工作和运营。”
此次故障导致Outlook电子邮件和日历管理功能,以及Microsoft 365的其他服务受到影响。政府机构、法院、医院、学校和企业等也报告了通信故障。微软表示,此次事故中未发现恶意活动。
7月发布的修复代码存在潜在缺陷
据微软介绍,故障始于位于Microsoft 365服务前端、负责处理用户请求的网络网关服务器。网关接收外部访问请求,并将其连接至Outlook和Teams等各项服务。
问题代码包含在去年7月专门为网关服务器发布的一项修复中。微软在数周内分阶段将其部署到全球服务器,此后三个多月未发现明显异常。
该代码存在一项缺陷:在特定负载条件下,服务器内部的多个任务会等待获取同一资源,这种情况称为“锁竞争”。锁竞争加剧时,请求处理会延迟,服务器也可能陷入无响应状态。
事前负载测试也未能发现这一缺陷。微软解释说,测试环境使用的服务器规格和流量配置与实际运营环境不同。尤其是锁竞争在处理器核心较多的新型服务器上会更加严重,但此前测试主要使用核心数相对较少的旧设备。
拉马纳表示,此次缺陷及修复代码仅适用于Microsoft 365网关服务器,不涉及常规Windows操作系统的部署环境。
Teams流量切换与服务器容量下降叠加
服务器负载增加和可用容量减少,使潜在缺陷最终演变成实际故障。
微软运营Microsoft 365时使用两套不同的网络网关系统。若其中一套出现问题,服务会切换至另一套网关,以减轻故障影响。
事故发生约15小时前,Teams流量从备用网关切换到了主网关。主网关同时承载支持Outlook电子邮件服务的Exchange Online。Teams流量增加后,服务器负载上升,请求处理模式也随之发生变化。
当时,约14%的网关服务器容量因前一天发生的另一项问题而处于停运状态。微软正通过定期维护和恢复流程修复这部分容量,并称仅凭容量减少尚不足以影响服务。
流量增加与服务器容量减少同时发生,触发了7月修复代码中的缺陷。用户请求开始积压,服务器陷入无响应状态。故障发生时正值美国服务使用高峰时段。
随后,自动流量切换功能进一步扩大了故障范围。微软系统会在服务器连接中断时,自动将用户请求转至正常服务器。但这次,从故障服务器转移过来的请求集中涌向剩余服务器,导致同一缺陷接连触发。
微软称,首次故障发生后不到两小时,问题便扩散至各地网关服务器。在故障最严重时,超过80%的网关服务器无响应。
阻止故障扩散的隔离机制也未能发挥作用
微软将网络网关划分为数千个容量单元,并按地区进行管理。这种结构旨在将各区域隔离,避免某一区域发生的问题扩散至其他区域。
此次事故中,原本用于阻止故障在不同区域间扩散的隔离机制因另一项问题未能发挥作用。从服务器开始的连锁故障越过区域边界,扩散至全球网关基础设施。
不同服务的恢复时间也有所差异。Teams、OneDrive、SharePoint和Office应用可以从出现问题的网关切换至其他路径,因此恢复相对较快。故障持续的大部分时间里,Teams聊天和会议功能都正常运行。
Exchange Online无法从相关网关切换至其他路径,因此电子邮件服务中断持续了更长时间。
微软:“最终报告将于本周发布”
恢复过程中也出现了问题。工程师重启服务器后,尚未处理的用户请求会一下子涌入,导致服务器再次陷入无响应状态。
原有自动恢复流程并未针对如此大范围的服务器同时停止响应的情况进行设计。由于包含缺陷的代码已在数月前部署,也难以通过常规的变更回滚流程或功能控制机制迅速撤回。
确认原因后,微软开发了更新,将出现问题的代码执行路径恢复至此前正常状态。随后,微软按一定规模将服务器暂时移出服务,应用修复后重启,再重新投入运营。在部分操作中,恢复流程涉及某一地区超过一半的服务器容量。
微软已在Microsoft 365管理中心发布此次事故的详细信息,并计划于本周内公布最终事故复盘报告。